Domain wahrscheinlichkeitsverteilung.de kaufen?
Wir ziehen mit dem Projekt
wahrscheinlichkeitsverteilung.de um.
Sind Sie am Kauf der Domain
wahrscheinlichkeitsverteilung.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain wahrscheinlichkeitsverteilung.de kaufen?
Was sind die gängigen Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigen Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Klassen oder Kategorien zu unterteilen und Muster zu erkennen. Sie werden häufig in der Informatik und Statistik eingesetzt, um Vorhersagen zu treffen oder Muster in den Daten zu identifizieren. **
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigsten Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Kategorien oder Klassen zu unterteilen und Muster oder Trends zu identifizieren. Sie werden häufig in der Informatik und Statistik eingesetzt, um Prognosen zu treffen oder Erkenntnisse aus den Daten zu gewinnen. **


Ähnliche Suchbegriffe für Klassifikation
Top-Angebote
Produkte zum Begriff Klassifikation:
-
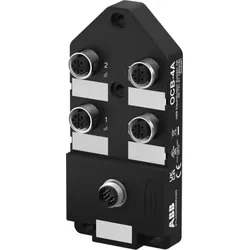
ABB OCB-3A Anschlussbox für OSSD-Signale individuelle Auswertung2TLA020055R3200 OCB-3A OCB-3A vereinfacht den Anschluss mehrerer Sensoren, da nur ein Kabel vom Schaltschrank zu den Sensoren verlegt werden muss.OCB-3A ist eine Anschlussbox für bis zu vier Eden OSSD-Sensoren mit M12-5-Pin-Stecker oder andere kompatible Sicherheitssensoren. Die Sicherheitssignale werden einzeln angeschlossen und können unterschiedliche Sicherheitsfunktionen haben.M12-12-Pin-Stecker für den Anschluss an die Sicherheitssteuerung im Schaltschrank.334,55 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter

-
Was sind die verschiedenen Methoden zur Klassifikation von Daten?
Die verschiedenen Methoden zur Klassifikation von Daten sind: Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Entscheidungsbäume teilen die Daten anhand von Merkmalen auf, künstliche neuronale Netze ahmen das menschliche Gehirn nach und Support Vector Machines finden die optimale Trennlinie zwischen den Datenpunkten. **
-
Was ist AO Klassifikation?
Die AO-Klassifikation ist ein System zur Klassifizierung von Frakturen, das von der Arbeitsgemeinschaft für Osteosynthesefragen (AO) entwickelt wurde. Sie dient dazu, Frakturen nach ihrem Schweregrad, ihrer Lokalisation und anderen relevanten Faktoren zu klassifizieren. Die AO-Klassifikation hilft Ärzten bei der Entscheidung über die geeignete Behandlung für eine bestimmte Fraktur und ermöglicht eine einheitliche Kommunikation über Frakturen in der medizinischen Fachwelt. Sie ist international anerkannt und wird häufig in der Orthopädie und Unfallchirurgie angewendet. Die AO-Klassifikation besteht aus verschiedenen Kategorien, die jeweils spezifische Informationen über die Fraktur liefern, um eine präzise Diagnose und Behandlung zu ermöglichen. **
-
Was ist die TNM Klassifikation?
Die TNM-Klassifikation ist ein System, das verwendet wird, um den Ausdehnungsgrad von Tumoren zu beschreiben. Dabei werden drei Hauptkriterien berücksichtigt: Tumorgröße (T), Lymphknotenbefall (N) und Metastasen (M). Anhand dieser Kriterien wird der Tumor in verschiedene Stadien eingeteilt, um eine Prognose abzugeben und die geeignete Behandlung zu bestimmen. Die TNM-Klassifikation wird vor allem in der Onkologie verwendet, um die Schwere und das Fortschreiten von Krebserkrankungen zu bestimmen. Sie dient auch dazu, den Verlauf der Erkrankung zu überwachen und die Wirksamkeit der Behandlung zu beurteilen. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik?
Die gängigsten Methoden zur Klassifikation von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu erkennen. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungelabelte Daten nutzt. **
Was sind die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft?
Die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning unlabeled Daten verwendet, um Muster und Strukturen zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungabelte Daten nutzt, um Modelle zu verbessern. **
"Was sind die grundlegenden Prinzipien der Klassifikation von Objekten oder Informationen?" "Warum ist die Klassifikation von Daten und Informationen in verschiedenen Bereichen und Disziplinen wichtig?"
Die grundlegenden Prinzipien der Klassifikation sind die Identifikation von Gemeinsamkeiten, die Gruppierung von ähnlichen Objekten und die Zuordnung zu Kategorien. Die Klassifikation von Daten und Informationen ist wichtig, um Ordnung zu schaffen, den Zugriff zu erleichtern und die Effizienz bei der Verwaltung zu erhöhen. In verschiedenen Bereichen und Disziplinen ermöglicht die Klassifikation eine bessere Organisation, Analyse und Nutzung von Informationen für spezifische Zwecke. **
Top-Angebote
Produkte zum Begriff Klassifikation:
-
Fettsäure-Analyse Selbsttest NorsanAnwendungsgebiet von Fettsäure-Analyse Selbsttest NorsanMit dem Fettsäure-Analyse Selbsttest Norsan können Sie bequem von Zuhause Ihre Fettsäurewerte bestimmen lassen. Gemessen wird das Omega-6/3-Verhältnis, der Omega3-Index sowie 26 Fettsäuren. Die Auswertung Ihres Blutes wird von einem unabhängigen Labor durchgeführt. Der individuelle Bedarf an Omega 3 lässt sich mithilfe des Selbsttests zur Analyse des Fettsäure- und Omega-Profils (NORSAN Analyse) belegen. Mit einigen Tropfen Blut aus der Fingerbeere wird Ihr Fettsäure-Profil analysiert und Sie erhalten unter anderem Informationen zu: Omega-3 Index: Gibt den Anteil der marinen Omega-3-Fettsäuren EPA und DHA im Verhältnis zu den gesamten Fettsäuren an. NORSAN empfiehlt einen Anteil von über 8 %. Omega 6/3-Verhältnis: Weist auf das Verhältnis zwischen Omega-6 und Omega-3-Fettsäuren hin, die bei der Entzündungsbildung und -hemmung entscheidend mitwirken. Ein zu hohes Omega-6/3 Verhältnis (Omega-3-Ratio) führt zu einem unerwünscht hohen Entzündungsniveau im Körper. Transfett-Anteil: Transfette sind Fettstoffe, die nicht natürlich in den Körper gehören. Transfette schaden den Zellen. Der Transfett-Anteil sollte niedrig sein. Es wird empfohlen, dass die industriellen Transfette weniger als 0,50 % der gesamten Fettsäuren ausmachen sollen. Wirkstoffe / Inhaltsstoffe / ZutatenIm Lieferumfang enthalten:- Bestellanforderung für die Blutanalyse - Blutentnahmeset mit Nadel- Folienbeutel- Test-Papier zum Auftrag des entnommenen Blutes und frankierten Rücksendeumschlag - Anleitung zur Blutentnahme und Anforderung des Analyseergebnisses - Auswertung durch ein unabhängiges Labor - Anschließend Befund mit ErnährungsempfehlungGegenanzeigenBei bekannter Überempfindlichkeit gegenüber einem der oben genannten Inhaltsstoffe sollte dieses Produkt nicht angewendet werden. Fettsäure-Analyse Selbsttest Norsan können in Ihrer Versandapotheke www.juvalis.de er70,76 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigen Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigen Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Klassen oder Kategorien zu unterteilen und Muster zu erkennen. Sie werden häufig in der Informatik und Statistik eingesetzt, um Vorhersagen zu treffen oder Muster in den Daten zu identifizieren. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigsten Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Kategorien oder Klassen zu unterteilen und Muster oder Trends zu identifizieren. Sie werden häufig in der Informatik und Statistik eingesetzt, um Prognosen zu treffen oder Erkenntnisse aus den Daten zu gewinnen. **
-
Was sind die verschiedenen Methoden zur Klassifikation von Daten?
Die verschiedenen Methoden zur Klassifikation von Daten sind: Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Entscheidungsbäume teilen die Daten anhand von Merkmalen auf, künstliche neuronale Netze ahmen das menschliche Gehirn nach und Support Vector Machines finden die optimale Trennlinie zwischen den Datenpunkten. **
-
Was ist AO Klassifikation?
Die AO-Klassifikation ist ein System zur Klassifizierung von Frakturen, das von der Arbeitsgemeinschaft für Osteosynthesefragen (AO) entwickelt wurde. Sie dient dazu, Frakturen nach ihrem Schweregrad, ihrer Lokalisation und anderen relevanten Faktoren zu klassifizieren. Die AO-Klassifikation hilft Ärzten bei der Entscheidung über die geeignete Behandlung für eine bestimmte Fraktur und ermöglicht eine einheitliche Kommunikation über Frakturen in der medizinischen Fachwelt. Sie ist international anerkannt und wird häufig in der Orthopädie und Unfallchirurgie angewendet. Die AO-Klassifikation besteht aus verschiedenen Kategorien, die jeweils spezifische Informationen über die Fraktur liefern, um eine präzise Diagnose und Behandlung zu ermöglichen. **
Ähnliche Suchbegriffe für Klassifikation
-
ABB OCB-3A Anschlussbox für OSSD-Signale individuelle Auswertung2TLA020055R3200 OCB-3A OCB-3A vereinfacht den Anschluss mehrerer Sensoren, da nur ein Kabel vom Schaltschrank zu den Sensoren verlegt werden muss.OCB-3A ist eine Anschlussbox für bis zu vier Eden OSSD-Sensoren mit M12-5-Pin-Stecker oder andere kompatible Sicherheitssensoren. Die Sicherheitssignale werden einzeln angeschlossen und können unterschiedliche Sicherheitsfunktionen haben.M12-12-Pin-Stecker für den Anschluss an die Sicherheitssteuerung im Schaltschrank.334,55 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
ABB OCB-4A Anschlussbox für potentialfreie Kontakte individuelle Auswertung2TLA020055R3300 OCB-4A OCB-4A vereinfacht den Anschluss von mehreren Sensoren, da nur ein Kabel vom Schaltschrank zu den Sensoren geführt werden muss.OCB-4A ist eine Anschlussbox für bis zu vier Sicherheitssensoren mit M12-5-Pin-Stecker. Die Sicherheitssignale werden einzeln angeschlossen und können unterschiedliche Sicherheitsfunktionen haben.M12-12-Pin-Stecker für den Anschluss an die Sicherheitssteuerung im Schaltschrank.334,55 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
LINARTS A2, Farbe nach Zufall, 1 StückTischmatte - mehrfach verwendbar, Material: PP, Abmessungen: 42 × 61 cm (H×B), Dicke: 1 mm Die LINARTS A2 Schreibtischunterlage dient dem Schutz der Arbeitsfläche vor Verschmutzung und Beschädigung. Sie eignet sich für Schulkinder, Heimwerker sowie für künstlerische Tätigkeiten, zum Beispie1,43 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Was ist die TNM Klassifikation?
Die TNM-Klassifikation ist ein System, das verwendet wird, um den Ausdehnungsgrad von Tumoren zu beschreiben. Dabei werden drei Hauptkriterien berücksichtigt: Tumorgröße (T), Lymphknotenbefall (N) und Metastasen (M). Anhand dieser Kriterien wird der Tumor in verschiedene Stadien eingeteilt, um eine Prognose abzugeben und die geeignete Behandlung zu bestimmen. Die TNM-Klassifikation wird vor allem in der Onkologie verwendet, um die Schwere und das Fortschreiten von Krebserkrankungen zu bestimmen. Sie dient auch dazu, den Verlauf der Erkrankung zu überwachen und die Wirksamkeit der Behandlung zu beurteilen. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik?
Die gängigsten Methoden zur Klassifikation von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu erkennen. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungelabelte Daten nutzt. **
-
Was sind die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft?
Die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning unlabeled Daten verwendet, um Muster und Strukturen zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungabelte Daten nutzt, um Modelle zu verbessern. **
-
"Was sind die grundlegenden Prinzipien der Klassifikation von Objekten oder Informationen?" "Warum ist die Klassifikation von Daten und Informationen in verschiedenen Bereichen und Disziplinen wichtig?"
Die grundlegenden Prinzipien der Klassifikation sind die Identifikation von Gemeinsamkeiten, die Gruppierung von ähnlichen Objekten und die Zuordnung zu Kategorien. Die Klassifikation von Daten und Informationen ist wichtig, um Ordnung zu schaffen, den Zugriff zu erleichtern und die Effizienz bei der Verwaltung zu erhöhen. In verschiedenen Bereichen und Disziplinen ermöglicht die Klassifikation eine bessere Organisation, Analyse und Nutzung von Informationen für spezifische Zwecke. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.